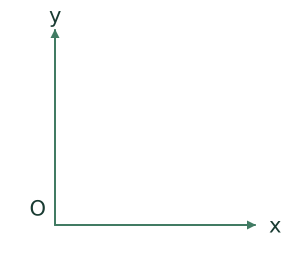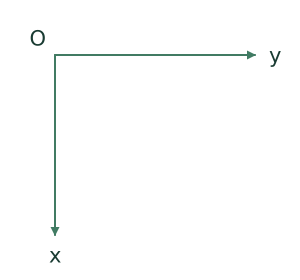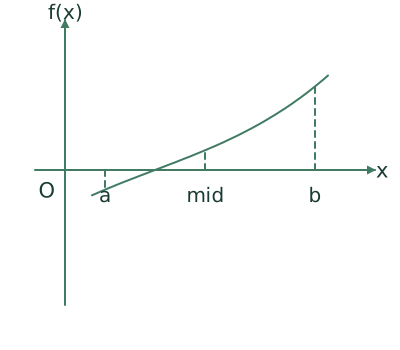using namespace std;
#define maxn 1000010
typedef long long LL;
LL a[maxn], n, m;
bool P(int h) { // 当砍树高度为 h 时,能否得到大于 m 的木材
LL tot = 0;
for (int i = 1; i <= n; i++)
if (a[i] > h)
tot += a[i] - h; // 按照题意模拟
return tot >= m;
}
int main() {
scanf("%lld%lld", &n, &m);
for (int i = 1; i <= n; i++)
scanf("%lld", &a[i]);
int L = 0, R = 1e9, ans, mid;
while (L <= R)
if (P(mid = L + R >> 1)) // 一种压行技巧
ans = mid, L = mid + 1;
// 如果 p(mid) 为真,mid 可以成为答案,真正的答案可能在 mid 右侧,左端点右移
else
R = mid - 1; // P(mid) 为假,答案在 mid 左侧,右端点左移
printf("%d", ans);
}
```
当然,这里 R 的初始值也可以设为所有树中最大的高度(因为答案不可能会比最高的还高)。判断条件是否成立的算法复杂度是 $O(n)$ ,而二分答案本身的算法复杂度是 $O(\log A)$ ,其中 A 是指最高的高度,因此总复杂度是 $O(n \log A)$ ,完全可以在规定的时间内得到答案。
使用二分答案技巧的条件:
1. 命题可以被归纳为找到使得某命题 $P(x)$ 成立(或不成立)的最大(或最小)的 $x$。
2. 把 $P(x)$ 看作一个值为真或假的函数, 那么它一定在某个分界线的一侧全为真, 另一侧全为假。
3. 可以找到一个复杂度优秀的算法来检验 $P(x)$ 的真假。
通俗来讲, 二分答案可以用来处理“最大的最小”或“最小的最大”问题。
#### 例 13-4 进击的奶牛(P1824, USACO 未知年份比赛)
一个牛棚有 n 个隔间, 它们分布在一条直线上, 坐标是 $x_{1}, x_{2}, \cdots, x_{n}$ 。现在需要把 c 头牛安置某些隔间, 使得所有牛中相邻两头的最近距离越大越好, 求这个最大的最近距离。
例如,有5个隔间、3头牛,隔间的坐标是[1,2,8,4,9]。可以将牛关在[1,4,9]这些隔间中,最近的距离是3。如果要求所有牛之间距离大于3,是办不到的。
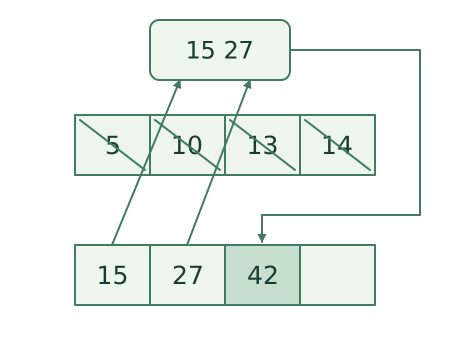
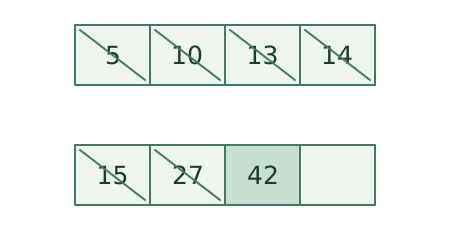
**分析:** 还是按照套路可以构造判断“条件”: 可以把 c 头牛全部安置进这些隔间使相邻两头牛距离不小于 $x$。于是先得检验单调性: 可以看出, x 越小, 就越可能把所有牛合法安置; 当 x 比较大时, 牛棚就不够安置了。于是不难想象, 存在一个分界线 ans, x 大于 ans 时没有合法安置方案, x 小于或等于 ans 时, 则一定存在合法安置方案。要找到这个 ans 作为答案。图 13-6 所示为间距条件成立的关系。
 图13-6 间距条件成立的关系
那么问题变为如何在优秀复杂度下检验“条件”的正确性。只有一个限制,即任意两个相邻安置点距离不能小于 $x$ 。于是可以大致感受到一种贪心算法:从最左端开始,每隔不小于 $x$ 的距离,能安置就安置,可以证明安置一定比不安置更优。最后只要看遍历所有点以后总共安置了多少头牛即可。代码如下:
```cpp
#include
#include
using namespace std;
#define maxn 1000010
#define INF 1e9
int a[maxn], n, c;
bool P(int d) {
int k = 0, last = -INF; // last 记录上一头牛的安置坐标
for (int i = 1; i <= n; i++)
if (a[i] - last >= d) // 能安置就立刻安置
last = a[i], k++;
return k >= c;
}
int main() {
scanf("%d%d", &n, &c);
for (int i = 1; i <= n; i++)
scanf("%d", &a[i]);
sort(a + 1, a + 1 + n);
int L = 0, R = INF, ans, mid;
while (L <= R) // 进行二分
if (P(mid = L + (R - L) / 2))
ans = mid, L = mid + 1;
else
R = mid - 1;
printf("%d", ans);
}
```
#### 例 13-5 一元三次方程求解(洛谷 P1024, NOIP2001 提高组)
解方程 $ax^{3}+bx^{2}+cx+d=0$ ,保证有 3 个实数根,且都在 $[-100,100]$ 上,还保证任意两根之差不小于 1。要求精确到小数点后 2 位。
**分析:** 和二次方程一样, 三次方程也有求根公式, 但是求根公式相当复杂, 而且中间步骤还涉及复变函数, 超过了中学数学的范围, 这里不讨论。
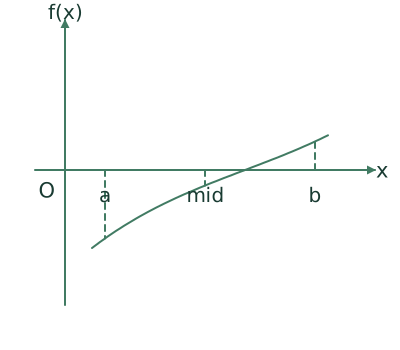
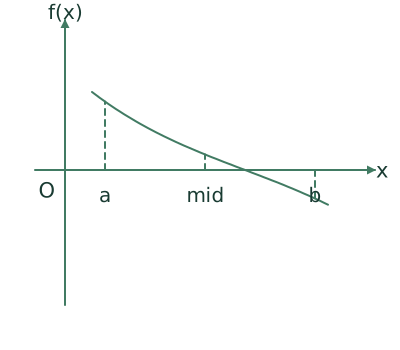
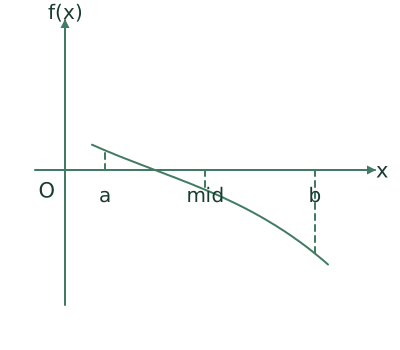
考虑用二分法求解。**零点存在性定理**说明:对连续函数 $f(x)$,若 $f(a)f(b)<0$ 且 $a图 13-7 二分求根的四种情况
因此,可以完成这样的程序。再次注意,实数之间不能直接比较是否相等,而是判断之间的差值是否小于 eps。
```cpp
#include
#include
#include
using namespace std;
#define eps 1e-4
double A, B, C, D;
double f(double x) {
return A * x * x * x + B * x * x + C * x + D;
}
int main() {
cin >> A >> B >> C >> D;
for (int i = -100; i <= 100; i++) {
double L = i, R = i + 1, mid; // 这里只处理区间 [L, R) 上的根
if (fabs(f(L)) < eps) // 如果 L 是根,可以直接输出
printf("%.2lf ", L);
else if (fabs(f(R)) < eps) // 如果 R 是根,跳过
continue;
else if (f(L) * f(R) < 0) { // 在 (L, R) 上有根,执行二分
while (R - L > eps) {
mid = (L + R) / 2;
if (f(mid) * f(R) > 0)
R = mid; // 如果 f(mid) 和 f(R) 正负性相同,那么零点在 mid 左侧
else
L = mid; // 否则在另一侧
}
printf("%.2lf ", L);
}
}
}
```
二分的次数和精度有关,但是考虑每次二分的区间都可以减小一半,缩减的速度还是很快的,因此也是对数级别。与整数区间二分有一点微妙的区别,实数区间上的二分需要确认好精度。题目要求输出保留两位小数,那么可以在二分端点相差不超过 $10^{-4}$ 时停止二分来确保精度。
### 13.3 课后习题与实验
**习题 13-1** 请模仿例题 13-1 的二分查找步骤, 手动模拟寻找数字 6 和 15 的步骤。需要每一轮都要写出对应的 l、r 和 mid 的值, 并记录下每轮二分的判断决策是什么。
**习题 13-2** 请尝试使用“记录答案”的二分模板实现二分查找。
**习题 13-3** 烦恼的高考志愿(洛谷 P1678)。现有 $m(m \leqslant 100000)$ 所学校, 每所学校预计录取分数线是 $a_{i}(a_{i} \leqslant 10^{6})$ 。有 $n(n \leqslant 100000)$ 位学生, 估分分别为 $b_{i}(b_{i} \leqslant 10^{6})$ 。根据预计分数线和学生的估分情况, 分别给每位学生推荐一所学校, 要求学校的预计录取分数线和学生的估分相差最小(可高可低, 毕竟是估分嘛), 这个最小值为不满意度。求所有学生不满意度和的最小值。
例如,学校预计录取分数线是[513,598,567,689],学生的估分是[500,600,550],分别给他们推荐分数线为[513,598,567]的学校,不满意度分别为[13,2,17],其和为32。没有更好的推荐方案。
**习题 13-4** 跳石头 [^note-31] (P2678, NOIP2015 提高组)。“跳石头”比赛将在一条笔直的河道中进行,河道中分布着一些巨大岩石,其中两块岩石作为比赛起点和终点,终点距离起点为 $L(L \leqslant 10^{9})$ 。在起点和终点之间,有 $N(N \leqslant 50000)$ 块岩石(不含起点和终点),距离起点的距离为 $D_{i}(0 < D_{i} < L)$ 。选手们将从起点出发,每一步跳向相邻的岩石,直至到达终点。
为了提高比赛难度,计划移走一些岩石,使得选手们在比赛过程中的最短跳跃距离尽可能长。至多从起点和终点之间移走 M 块岩石(不能移走起点和终点的岩石)。求最短跳跃距离的最大值。
**习题 13-5** 木材加工(洛谷 P2440)。木材厂有一些原木,现在想把这些木头切割成一些长度相同的小段木头(木头有可能有剩余),需要得到的小段的数目是给定的。当然,这里希望得到的小段木头越长越好,任务就是计算能够得到的小段木头的最大长度。原木的长度都是正整数,要求切割得到的小段木头的长度也是正整数。例如有两根原木长度分别为 11 和 21,要求切割成到等长的 6 段,很明显能切割出来的小段木头长度最长为 5。
**习题 13-6** 路标设置(洛谷 P3853, 天津市队选拔 2007)。B 市和 T 市之间有一条 $L(L \leqslant 10^{7})$ 公里的高速公路, 这条公路的 $N (N \leqslant 100000)$ 个点上设有路标。把公路上相邻路标的最大距离定义为该公路的“空旷指数”。现在政府决定在公路的整数公里点上增设 $K (K \leqslant 100000)$ 个路标,使得公路的“空旷指数”最小。因此需要设计一个程序计算能达到的最小值是多少。请注意,公路的起点和终点保证已设有路标, 公路的长度为整数, 并且原有路标和新设路标都必须距起点整数个单位距离。
**习题 13-7** 数列分段 - Section II(洛谷 P1182)。对于给定的一个长度为 $N (N \leqslant 100000)$ 的正整数数列 $A_{i} (A_{i} \leqslant 10^{9})$ , 现要将其分成 $M (M \leqslant N)$ 段, 并要求每段连续, 且每段和的最大值最小。例如, 一数列 [4,2,4,5,1] 要分成 3 段, 将其分成 [4,2][4,5][1] 时, 第一段和为 6 , 第 2 段和为 9 , 第 3 段和为 1 , 和最大值为 9 ; 将其分成 [4][2,4][5,1] 时, 第一段和为 4 , 第 2 段和为 6 , 第 3 段和为 6 , 和最大值为 6 ; 无论如何分段, 最大值不会小于 6 。求每段和最大值最小为多少。
**习题 13-8** 银行贷款(洛谷 P1163)。当一个人从银行贷款后,在一段时间内这人将不得不每月偿还固定的分期付款。已知贷款的本金 P,每月支付的分期付款金额 A,分期付款还清贷款所需的总月数 M。这个问题要求计算出贷款者向银行支付的月利率 ans,按百分比输出。
**提示:** $\sum_{i=1}^{M} A \times \left( \frac{1}{1 + \text{ans}} \right)^i = P$ ,而且月利息最高可高至 $500\%$ 。
**习题13-9(选做)** Kotori的设备(洛谷P3743)。Kotori有 $n(n\leqslant100000)$ 个可同时使用的设备,第i个设备平均每秒均匀消耗 $a_{i}(a_{i}\leqslant10^{6})$ 个单位能量(每时每刻都在消耗,并不是每一秒钟一下子扣除 $a_{i}$ 能量)。在开始的时候第i个设备里存储着 $b_{i}(b_{i}\leqslant10^{6})$ 个单位能量。
同时Kotori又有一个可以给任意一个设备充电的充电宝,平均每秒可以给接通的设备充能 $p(p\leqslant10^{6})$ 个单位,充能也是连续的。可以在任意时间给任意一个设备充能,从一个设备切换到另一个设备的时间忽略不计。Kotori想把这些设备一起使用,直到其中有设备能量降为0。所以Kotori想知道,在充电器的作用下,最多能将这些设备一起使用多久(至少精确到6位小数)。
## 第14章 搜索
在之前的章节介绍了暴力枚举策略,将所有可能的情况都枚举一遍以获得最优解,但是枚举全部元素的效率如同愚公移山,无法应付数据范围稍大的情形。本章将在暴力枚举的基础上介绍搜索算法,包括深度优先搜索和广度优先搜索,从起点开始,逐渐扩大寻找范围,直到找到需要的答案为止。
严格来说,搜索算法也算是一种暴力枚举策略,但是其算法特性决定了效率比直接的枚举所有答案要高,因为搜索可以跳过一些无效状态,降低问题规模。在算法竞赛中,如果选手无法找到一种高效求解的方法(如贪心、递推、动态规划、公式推导等),使用搜索也可以解决一些规模较小的情况;而有的任务就是必须使用搜索来完成,因此这是相当重要的策略。图 14-1 所示为本章思维导图。
 图14-1 本章思维导图
### 14.1 深度优先搜索与回溯法
有些题目,无法用简单的循环表示所有枚举情况,需要寻找更加一般化的枚举框架;有些题目,本质上是子集枚举或是排列枚举,但是枚举量过大,需要剪掉过多的无效状态……深度优先搜索应运而生。
#### 例 14-1 四阶数独
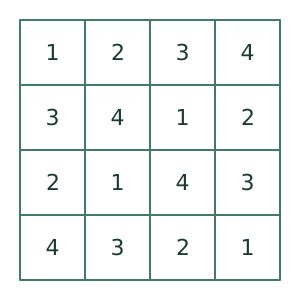
数独是一种著名的益智游戏。这里讨论的是一种简化过的数独——四阶数独。给出一个 $4 \times 4$ 的格子,每个格子只能填写 1 到 4 的整数,要求每行、每列和四等分更小的正方形部分都刚好由 1 到 4 组成。图 14-2 所示是一个合法的四阶数独的例子。
给出空白的方格,请问:一共有多少种合法的填写方法?
| 2 | 4 | 1 | 3 |
| --- | --- | --- | --- |
| 1 | 3 | 2 | 4 |
| 4 | 2 | 3 | 1 |
| 3 | 1 | 4 | 2 |
**分析:** 最朴素的枚举方式是,一共有16个选项,每个空格可以填1到4,所以考虑使用16层for循环。一共有 $4^{16}$ 大约是42亿种情况。显然这种方式非常低效,不可行。
**图14-2 四阶数独的一个例子**
解法 1: 之前的章节讨论过枚举序列。既然每一行都是 1 到 4, 假设各行都是独立的, 分别枚举 4 个 1 到 4 的全排列, 组成一个 $4 \times 4$ 的矩阵, 然后判断这个矩阵是否符合数独的要求。可以使用类似计数排序的思路判断是否符合要求, 也就是记录第 i 行是否有 1、2、3、4, 如果每个数字刚好都有一个, 则说明这一行符合要求; 列和小块也是一样的道理。最多可能有 $(4 \times 3 \times 2 \times 1)^{4} = 331776$ 种情况, 完全可以在一秒钟内运行出结果, 请读者尝试自己实现代码。
解法 2: 解法 1 还是有一些浪费: 如果第一行是 [1,2,3,4], 第二行第一列是 1, 后面不管怎么填写, 都不符合要求, 但是还是继续进行无谓的枚举然后判断。显然, 这种方法不适用于传统的 9 阶数独 (需要枚举天文数字)。希望在枚举序列的时候, 一旦发现某位数字不符合要求, 就立刻中断这种情况的枚举, 赶快枚举下一种情况。这样可在很大程度上节约程序的运行时间。
传统枚举中需要固定 `for` 循环的层数,但是这会造成程序非常冗长,而且不能随意增减枚举层数。本章将介绍一种新的利用函数递归枚举的方式,枚举每一个填空中所有可能的选项,然后判断这种选项是否合法。如果这个选项合法的话就填写下一个选项,然后继续;如果这个填空中所有的选项都不合法,那就不用继续枚举下去了,而是去尝试更换上一个填空的选项,继续枚举。这种方式称为回溯算法,常使用深度优先搜索来实现。
回溯算法的一般形式如下:
**递归框架(伪代码):**
```text
void dfs(int k) { // k 代表递归层数,或者说要填第几个空
if (所有空已经填完了) {
判断最优解 / 记录答案;
return;
}
for (枚举这个空能填的选项)
if (这个选项是合法的) {
记录下这个空(保存现场);
dfs(k + 1);
取消这个空(恢复现场);
}
}
```
完整程序如下:
```cpp
#include
#include
using namespace std;
#define size 5
int a[size * size], n = 4 * 4, ans = 0;
int b1[size][5], b2[size][5], b3[size][5]; // 分别记录横行,竖行,四小块
void dfs(int x) { // 第×个空填什么
if (x > n) { // 如果所有空已经填满
ans++; // 增加结果数量
/* 以输出放置方案
for (int i = 1; i <= n; i++) {
printf("%d ", a[i]);
if (i % 4 == 0) puts("");
}
puts("");
*/
return;
}
int row = (x - 1) / 4 + 1; // 横行编号
int col = (x - 1) % 4 + 1; // 竖排编号
int block = (row - 1) / 2 * 2 + (col - 1) / 2 + 1; // 小块编号
for (int i = 1; i <= 4; i++)
if (b1[row][i] == 0 && b2[col][i] == 0 && b3[block][i] == 0) {
a[x] = i; // 记录放置位置
b1[row][i] = 1;
b2[col][i] = 1;
b3[block][i] = 1; // 占位
dfs(x + 1); // 下一层递归
b1[row][i] = 0;
b2[col][i] = 0;
b3[block][i] = 0; // 取消占位
}
}
int main() {
dfs(1);
printf("%d", ans);
return 0;
}
```
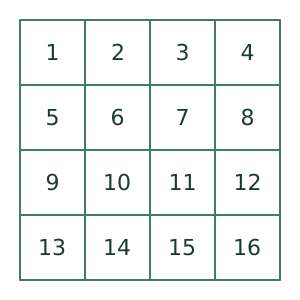
如何保证放置的位置合法呢?需要数组 b1、b2、b3 来记录横行、竖行、四小块中每个数字 i 是否被占用。如果都没有被占用,说明可以填入。把这些空格进行编号为 1 到 16,如图 14-3(a),同时它们占的行号、列号和小块编号都可以计算出来,如图 14-3(b)、(c)、(d) 所示。请读者自行证明。
如果感觉不太能理解搜索具体的步骤,没有关系,接下来详细介绍搜索回溯的详细步骤(图 14-4)。
1. 进入第1层dfs函数, $k = 1$ 。要枚举第1个格子的数字,先从1开始。这里填1没有问题,就把1记录下来,同时需要记录第1行、第1列、第1小块“1”已经被填写过了,继续递归dfs(2)。
图 14-3 四阶数独的编号
编号 `x` 从 1 到 16,对应的行、列和宫编号为(`/` 表示整数除法):
```cpp
row = (x - 1) / 4 + 1;
col = (x - 1) % 4 + 1;
block = (row - 1) / 2 * 2 + (col - 1) / 2 + 1;
```
图 14-4 依次填写数独
2. 进入第 2 层 `dfs` 函数, k=2。要枚举第 2 个格子的数字, 先从 1 开始, 发现第一行已经有 1 了, 不行; 于是尝试填入 2, 没问题, 就记录 2, 同时记录第 1 行、第 2 列、第 1 小块 “2” 已经填写过了, 继续递归 `dfs(3)`。
3. 进入第 3 层 `dfs` 函数, k=3。要枚举第 3 个格子的数字。填写 1 和 2 是不行的, 但是可以填写 3。同时记录下第 1 行、第 3 列、第 2 小块 “3” 已经填写过了, 继续递归 `dfs(4)`。
4. 进入第 4 层 `dfs` 函数, k=4。要枚举第 4 个格子的数字。这里只能填写 4 了, 然后记录下来, 继续递归 `dfs(5)`。
5. 进入第 5 层 `dfs` 函数, k=5。要枚举第 5 个格子的数字。1 不行(第一列重复), 2 也不行(第一小块重复), 填写 3, 同时记录第 2 行、第 1 列、第 1 小块 “3” 已经填写过了, 继续递归 `dfs(6)`。
6. 一直到 `dfs(16)` 填写完最后一个数字 “1” 后, 继续递归 `dfs(17)`。发现 k=17 意味着所有格子已经填写完毕, 得到了一个合法的解, 因此记录答案, 然后返回上一层, 也就是在 `dfs(16)` 中继续枚举 2、3、4……如果没有可行解, 就再返回上一层 `dfs(15)`, 继续往后枚举。
如果在运行到某一层的时候所有选项都不是合法的,那么自然是不能继续往下面递归的。遇到这种情况,就返回到上一层,然后继续枚举。如图14-5所示,在dfs(11)中所有选项均不合法,就回退到dfs(10)。原来的dfs(10)中i=1,于是就继续枚举剩余的选项,比如i=2(不合法),i=3(合法),然后继续前进到dfs(11)。
 图14-5 回溯与栈空间
为什么返回上一层还能继续枚举呢?这是因为计算机运行函数时,为每一个子函数都分配了一片栈空间,专门用于存储每一层递归函数的信息,当然就包括每层函数的各个局部变量的值了。
遇到了需要枚举排序的时候,搜索回溯会很好用。不需要生成所有的序列全排列,而是一个一个地填空,保证填空的时候序列是合法的,这样就可以不用枚举很多无效序列,节约程序运行时间。
#### 例 14-2 八皇后(洛谷 P1219, USACO Training)
在 $n \times n$ 的国际象棋棋盘上放置 n 个皇后使得她们互不攻击。皇后的攻击范围是同一行、同一列、在同斜线上的其他棋子。n 不超过 13,求方案数,并输出前 3 种放法。
**分析:** 本题也是非常经典的搜索回溯例题。考虑到每一行只能放一个,且所有行放在第几列都是不相同,所以可以对 n 进行枚举全排列(这样就能保证皇后不会攻击到同一行、同一列的其他皇后),然后判断是否有两个皇后在同一斜线上。这种方法比较低效,可以考虑使用搜索回溯算法进行优化。
假设 n=4,那么求解可以认为是将 1、2、3、4 填入 4 个空中,代表每一行第几列有一个棋子。填空的时候保证填入的棋子不会和之前的棋子冲突。和上一例类似,写出如下代码:
```cpp
#include
using namespace std;
#define maxn 100
int a[maxn], n, ans = 0;
int b1[maxn], b2[maxn], b3[maxn]; // 分别记录 y, x + y, x - y + 15 是否被占用
void dfs(int x) { // 第 x 行的皇后放哪儿
if (x > n) { // 如果所有皇后已经放置
ans++; // 增加结果数量
if (ans <= 3) { // 输出前三种答案
for (int i = 1; i <= n; i++)
printf("%d ", a[i]);
puts("");
}
return;
}
for (int i = 1; i <= n; i++)
if (b1[i] == 0 && b2[x + i] == 0 && b3[x - i + 15] == 0) {
a[x] = i; // 记录放置位置
b1[i] = 1;
b2[x + i] = 1;
b3[x - i + 15] = 1; // 占位
dfs(x + 1); // 下一层递归
b1[i] = 0;
b2[x + i] = 0;
b3[x - i + 15] = 0; // 取消占位
}
}
int main() {
scanf("%d", &n);
dfs(1);
printf("%d", ans);
return 0;
}
```
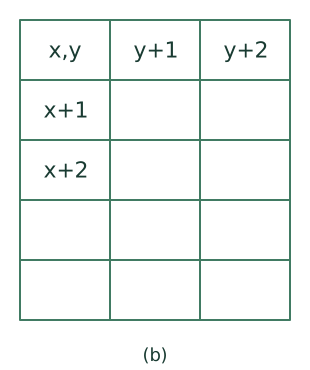
因为分行枚举棋子位数,所以每行不会冲突。在这里使用b1数组,记录下b1[i]说明第i列已经被占。那如何记录某一个斜排被占呢?可以发现,对于同一个斜行上的所有坐标点 $(x,y)$ 中, $x+y$ 或者x-y是定值,如图14-6所示。因此设立b2和b3数组,`b2[i]`用来记录和 $x+y=i$ 的斜线是否被占用,`b3[i]`用来记录 $x-y+15=i$ 的斜线是否被占用 $(x-y$ 可能小于0,普通的数组不能负下标,因此加上15的偏移量保证数组下标非负)。
如果打算填写的位置被占了(竖排、斜排),就不能填写在这个位置了。
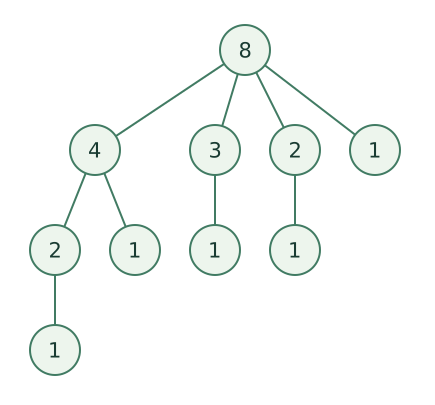
这个例子的状态比较少,可以把所有的状态流程都画出来,如图 14-7 所示。这样的树形结构称为解答树。从这个解答树可以看出,只枚举了 16 种状态,末端结点更是只有 6 种,相比于直接枚举全排列($4! = 24$),有了很大的改进。从图中可以看出,深度优先搜索是“不撞南墙不回头”,除非碰到了无解状态,就会往一个方向搜索。只有搜索到头了(无解或者找到解)才会返回之前的状态。
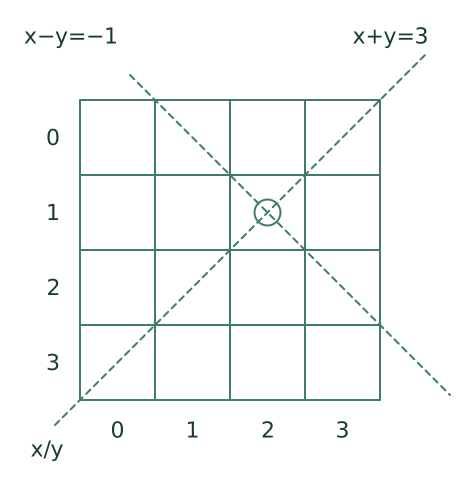 图14-6 斜角占位
#### 例 14-3 kkksc03 考前临时抱佛脚(洛谷 P2392)
有 4 个科目的作业, 每个科目有不超过 20 题, 解决每道题都需要一定的时间。kkksc03 可以同时处理同一科目的两道不同的题, 求他完成所有题目所需要的时间。
**分析:** 由于 kkksc03 只能一科一科地完成作业,所以这四个科目相对独立,可以仅考虑一个科目的情况。对于一个科目的题目来说,需要分成两组,当这两组分别的耗时总和最为接近时,完成这一科的耗时最小(否则,kkksc03 的大脑一边是闲置的,造成浪费)。因此,只需要从这些题目中取其中一部分作为一个子集,使这些题目总耗时不超过这个科目的总耗时的一半,但是尽可能的大。这样就可以将这个科目的题目分为尽可能均等的两部分了。
 图14-7 完整的解答树,右下角的数字代表遍历顺序
之前的章节讨论过了枚举子集——每个题目放入或者不放入子集中。使用介绍过的二进制法,需要最多枚举 $2^{20}$ 次,大约是100万次,虽然不是不可接受,但是仍然有不少浪费:已经选择了一些题目了,这些题目耗时超过了所有题目总耗时的一半,那这些题目的集合就不是一个合法的集合,也就没有继续枚举加入其他题目的必要了。这里还是使用搜索回溯算法——只是选项更加简单,这个题目加入还是不加入子集中,代码如下:
```cpp
#include
#include
using namespace std;
int nowtime, maxtime, sum; // 子集中的时间和、最大合法时间和、该课作业总时长
int ans, maxdeep; // 答案,最深递归层数限制(作业数量)
int s[4], a[21]; // 每科作业数量,每个作业的耗时
void dfs(int x) {
if (x > maxdeep) { // 所有作业枚举完毕,达到了最大递归层数
maxtime = max(maxtime, nowtime); // 如果解更优,更新答案。
return;
}
if (nowtime + a[x] <= sum / 2) { // 如果放入这个作业是合法的,选择它
nowtime += a[x]; // 增加子集中这道题目的时间
dfs(x + 1); // 下一层递归
nowtime -= a[x]; // 去除掉子集中这道题目的时间
}
dfs(x + 1); // 不选这个题目,直接进行下一层递归
}
int main() {
cin >> s[0] >> s[1] >> s[2] >> s[3];
for (int i = 0; i < 4; i++) { // 四种科目
nowtime = 0;
maxdeep = s[i];
sum = 0; // 别忘了每次换科目都要初始化
for (int j = 1; j <= s[i]; j++) {
cin >> a[j];
sum += a[j]; // 记录这科作业总耗时
}
maxtime = 0;
dfs(1); // 开始枚举第一个题目
ans += (sum - maxtime); // 加上答案
}
cout << ans;
return 0;
}
```
在这个递归程序中,虽然没有 `for` 循环枚举“所有能填的空”,但依然有两种决策——取这个题目或者不取。取之前需要判断加入这个题目后会不会导致子集耗时超过总耗时的一半,如果没有超过就增加 maxtime 的值然后进行下一层枚举。当然也可以不加入到子集中,直接进行下一层枚举。如果不需要输出具体要选择那些题目,甚至不需要建立一个数组来储存选择了哪些题目。
对于一些枚举或者枚举子集的问题,可以使用搜索回溯来解决。但如果需要枚举的元素比较多(超过几十个),即使是搜索回溯也相当慢。可以使用动态规划的背包问题模型更高效地解决本题。
### 14.2 广度优先搜索
深度优先搜索会优先考虑搜索的深度。形象点说,就是不找到一个答案不回头。当答案在整棵解答树中比较稀疏时,深度优先搜索可能会先陷入过深的情况,一时半会儿找不到解。有时候需要解决连通性、最短路问题时,可以考虑使用广度优先搜索。
#### 例 14-4 马的遍历(洛谷P1443)
有一个 $n \times m$ 的棋盘 $(1 < n, m \leqslant 400)$ , 在某个点上有一个马, 要求计算出马到达棋盘上任意一个点最少要走几步。
**分析:** 这里即将介绍的广度优先搜索,会优先考虑每种状态的和初始状态的距离,形象点说,与初始状态越接近的情况就会越先考虑。再具体一点:每个时刻(阶段)要做的事情就是从上个时刻(阶段)每个状态扩展出新的状态。
广度优先搜索使用队列 [^note-32] 实现:先将初始状态加入到空的队列中,然后每次取出队首,找出队首所能转移到的状态,再将其压入队列;如此反复,直到队列为空。在每次转移代价相同(例如无权图每条边的长度均为 1)的前提下,首次到达状态的路径才保证具有最少的转移次数;一般带权最短路不能直接套用这个结论。
广度优先搜索的一般形式如下:
```text
Q.push(初始状态); // 将初始状态入队
while (!Q.empty()) {
State u = Q.front(); // 取出队首
Q.pop(); // 出队
for (枚举所有可扩展状态) // 找到 u 的所有可达状态 v
if (是合法的) // v 需要满足某些条件,如未访问过、未在队内等
Q.push(v); // 入队(同时可能需要维护某些必要信息)
}
```
就本题而言,先建立一个结构体数组用于存储扩展的结点。先让起点入队,然后在队列取状态逐个扩展。容易被证明每个点被扩展到时一定是最少步数。又因为每个点只被扩展了一次,所以复杂度是 $O(mn)$ 。代码如下:
```cpp
#include
#include
#include
#include
using namespace std;
#define maxn 310
struct coord { // 一个结构体存储x,y两个坐标
int x, y;
};
queue Q; // 队列
int ans[maxn][maxn]; // 记录答案,-1表示未访问
int walk[8][2] = {{2, 1}, {1, 2}, {-1, 2}, {-2, 1},
{-2, -1}, {-1, -2}, {1, -2}, {2, -1}}; // 马能走的8个方向
int main() {
int n, m, sx, sy;
memset(ans, -1, sizeof(ans));
cin >> n >> m >> sx >> sy;
coord tmp = {sx, sy};
Q.push(tmp); // 使起点入队扩展
ans[sx][sy] = 0;
while (!Q.empty()) { // 循环直到队列为空
coord u = Q.front(); // 拿出队首以扩展
int ux = u.x, uy = u.y;
Q.pop();
for (int k = 0; k < 8; k++) {
int x = ux + walk[k][0], y = uy + walk[k][1];
int d = ans[ux][uy];
if (x < 1 || x > n || y < 1 || y > m || ans[x][y] != -1)
continue; // 若坐标超过地图范围或者该点已被访问过则无需入队
ans[x][y] = d + 1; // 记录答案,是上一个点多走一步的结果。
coord tmp = {x, y};
Q.push(tmp);
}
}
for (int i = 1; i <= n; i++, puts(""))
for (int j = 1; j <= m; j++)
printf("%-5d", ans[i][j]); // 场宽输出
return 0;
}
```
当输入为 `4 4 1 1` 时, 扩展方向如图 14-8(a), 队列如图 14-8(b) 所示。图 14-8 只展示了部分步骤。
 图14-8 广度优先搜索的步骤
广度优先搜索的步骤如下:
1. 队列最开始是空。将起始结点(1,1)加入到队列中。
2. 取出队首元素, 得到队首元素是(1,1), 枚举8个方向的偏差值, 加入到队首元素的坐标, 发现(3,2)和(2,3)没有超出地图范围, 也没有访问过。于是将其加入到队列中末尾, 同时更新步数答案。
3. 取出队首元素, 得到队首元素是(3,2), 枚举8个方向的偏差值, 加入到队首元素的坐标, 发现(4,4)、(2,4)和(1,3)没有超出地图范围, 也没有访问过。于是将其加入到队列末尾, 同时更新步数答案。
4. 取出队首元素, 得到队首元素是(2,3), 枚举8个方向的偏差值, 加入到队首元素的坐标, 发现(3,1)和(4,2)没有超出地图范围, 也没有访问过。于是将其加入到队列末尾, 同时更新步数答案。
5. 使用同样的方式, 取出队首元素, 枚举 8 个方向, 将合法的可扩展的点加入到队列末尾, 更新步数答案。(扩展之后的点没有在上图中体现出来)
6. 直到队列为空, 结束流程。
#### 例 14-5 奇怪的电梯(洛谷 P1135)
有一个 $N(N \leqslant 200)$ 层大楼, 里面有一部奇怪的电梯。大楼的每一层楼都可以停电梯, 而且第 $i(1 \leqslant i \leqslant N)$ 层楼上有一个数字 $K_{i}(0 \leqslant K_{i} \leqslant N)$ 。电梯只有“上”和“下”两个按钮, 上下的层数等于当前楼层上的那个数字。当然, 如果不能满足要求, 相应的按钮就会失灵。
例如: $k=[3,1,2,2,2,4,1]$ 时,在1楼,按“上”可以到4楼,按“下”不起作用,因为没有-2楼;而在2楼,按“上”可达3楼,按“下”到1楼。那么,从A楼到B楼至少要按几次按钮呢?(1—4—2—3—5—7,一共5次)。
**分析:** 思路其实很简单:从起点开始,往上或者往下扩展,可以到达“按1次按钮的地方”。这些“按1次按钮的地方”再分别往上或往下扩展(前提是在大厦范围内,且没有访问过),就可以到达“按2次按钮的地方”。刚好可以使用广度优先搜索解决这个问题,代码如下:
```cpp
#include
#include
using namespace std;
struct node {
int floor, d; // 队列中记录的层数和按钮次数
};
queue Q; // 广度优先搜索的队列
int n, a, b;
int k[1000], vis[1000]; // 每层楼上下可以跳跃几层,以及是否访问过
int main() {
cin >> n >> a >> b;
for (int i = 1; i <= n; i++)
cin >> k[i];
Q.push((node){a, 0}); // 将初始元素加入到队列
vis[a] = 1; // 记录初始楼层已访问过
node now;
while (!Q.empty()) {
now = Q.front();
Q.pop();
if (now.floor == b)
break; // 找到目标解
for (int sign = -1; sign <= 1; sign += 2) { // sign 枚举 -1 和 1
int dist = now.floor + k[now.floor] * sign; /* 目标楼层,sign 为 1 是上 */
if (dist >= 1 && dist <= n && vis[dist] == 0) {
// 如果按按钮能到达的楼层有效并且未访问过该楼层
Q.push((node){dist, now.d + 1});
vis[dist] = 1; // 该楼层为已访问过
}
}
}
if (now.floor == b) // 找到目标解
cout << now.d << endl;
else // 无法到达
cout << -1 << endl;
return 0;
}
```
这个例子各个楼层关系如图 14-9(a) 所示, 扩展结点的时候就是按照这样的方向和流程。广度优先搜索解答树也是可以画出来的, 如图 14-9(b) 所示。可以发现, 广度优先搜索从起点开始, 依次扩展。先枚举完所有近处的结点, 然后再依次扩展比较远的结点, 而不是如同深度优先搜索一样一直往前走。基于这个特性, 广度优先搜索可以找到步骤最少、距离最近的解, 代价是必须使用队列来存储所有的结点信息, 占用比较多的内存空间。
**图14-9 楼层的关系图和解答树**
对于同一个模型,无论使用深度优先搜索还是广度优先搜索,其解答树是一样的,只是搜索顺序不一样。这里给出一个直观地比较两种搜索解答树和搜索顺序的例子,如图 14-10 所示。
同样是寻找目标解,深度优先搜索寻找操作步骤字典序最小的解,而广度优先搜索可以找到步骤最少的解。需要根据题目的性质来决定使用什么搜索算法。
#### 例 14-6 流星雨(洛谷 P2895, USACO2008 2 月)
奶牛 Bessie 从原点出发躲避流星雨。一共有 $M(M \leqslant 50000)$ 个流星,已知每颗流星掉下的坐标(0 到 300)和时间(0 到 1000),并且流星掉下来会烧焦坐标以及上、下、左、右共 5 个点。奶牛每个单位时间可以往上下左右移动一格,但是不能移动到已经烧焦或在到达时刻恰好被烧焦的点;未来才被烧焦的点,在烧焦前仍可经过。问奶牛能否抵达安全区域以及最短的逃跑时间是多少?
**分析:** 这题看上去十分复杂, 但本质上只是对格子多了个使用时间的限制。可以预先处理出每个格子最早(如果有)被流星雨砸中的时间,那么在状态转移时,如果目标格子的(最早)到达时间不早于被破坏时间,就不能被扩展了。主体部分和上题非常接近,代码如下:
 图 14-10 广度优先搜索和深度优先搜索
```cpp
#include
using namespace std;
#define maxn 310
struct coord {
int x, y;
};
queue Q;
int ans[maxn][maxn], death[maxn][maxn]; // death 表示该点被流星雨砸中的时间
int wk[4][2] = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};
int main() {
int m, Ans = 100000;
memset(ans, -1, sizeof(ans)); // 全部赋值为 -1
memset(death, 0x7f, sizeof(death)); // 全部赋值为一个很大的值,约 2.14e9(32位 int)
cin >> m;
for (int i = 1; i <= m; i++) {
int x, y, t;
cin >> x >> y >> t;
#define MIN(x, y, t) \
if (x >= 0 && y >= 0 && x < maxn && y < maxn) \
death[x][y] = min(death[x][y], t)
MIN(x, y, t);
for (int k = 0; k < 4; k++)
MIN(x + wk[k][0], y + wk[k][1], t);
// 记录下流星和上下左右影响范围烧焦的时间
}
if (death[0][0] == 0) {
cout << -1;
return 0;
}
Q.push(coord{0, 0}); // 原点加入到队列
ans[0][0] = 0;
while (!Q.empty()) {
coord u = Q.front(); // 取出队首
int ux = u.x, uy = u.y;
Q.pop();
for (int k = 0; k < 4; k++) { // 奶牛向 4 个方向运动
int x = ux + wk[k][0], y = uy + wk[k][1];
if (x < 0 || y < 0 || x >= maxn || y >= maxn || ans[x][y] != -1 ||
ans[ux][uy] + 1 >= death[x][y])
continue; /* 当目标格子的最早到达时间已经比被破坏时间晚时不能更新 */
ans[x][y] = ans[ux][uy] + 1;
Q.push(coord{x, y}); // 扩展的结点加入队列
}
}
for (int i = 0; i <= 305; i++)
for (int j = 0; j <= 305; j++)
if (death[i][j] > 1000 && ans[i][j] != -1)
Ans =
min(Ans,
ans[i][j]); /* 统计答案:在所有安全区域且能到达的点中找到达最早的 */
if (Ans == 100000)
puts("-1");
else
printf("%d", Ans);
return 0;
}
```
将一个结构体放入队列,除了像上例一样建立一个临时结构体 tmp 记录坐标后加入队列,还可以像本例这样直接使用类型强制转换构建结构体,就像 `Q.push((coord){x,y})` 这样。
另外可能会觉得头文件太多了,这里可以使用所谓的“万能头文件”#include``代替那一堆头文件。使用万能头文件必须要确定允许使用时才能加上,因为不是所有的地方都支持。现在(2019年),NOI系列比赛支持使用万能头文件。使用万能头文件会出现一些潜在的副作用(比如一些变量被定义了),所以请确保程序能够在评测环境中编译通过后谨慎使用。
### 14.3 课后习题与实验
**习题 14-1** 考察以下的任务(“暴力枚举”一章出现过的题目),请使用回溯搜索实现。
(1) 选数(洛谷 P1036, NOIP2002 普及组)。
(2) Perket(洛谷 P2036)。
(3) 吃奶酪(洛谷 P1433)。
**习题 14-2** 迷宫(洛谷 P1605)。给定一个 $N \times M (1 \leqslant N, M \leqslant 5)$ 方格的迷宫, 迷宫里有 T 处障碍, 障碍处不可通过。给定起点坐标和终点坐标, 问: 每个方格最多经过 1 次, 有多少种从起点坐标到终点坐标的方案。在迷宫中移动有上下左右 4 种方式, 每次只能移动一个方格。数据保证起点上没有障碍。
**习题 14-3** 单词接龙(洛谷 P1019, NOIP2000 提高组)。单词接龙是一个与人们经常玩的成语接龙相类似的游戏, 现在已知一组不超过 20 个单词, 且给定一个开头的字母, 要求出以这个字母开头的最长的“龙”(每个单词都最多在“龙”中出现两次)。在两个单词相连时, 其重合部分合为一部分, 例如 beast 和 astonish, 如果接成一条龙则变为 beastonish。另外相邻的两部分不能存在包含关系, 例如 at 和 atide 间不能相连。只需要输出以此字母开头的最长的“龙”的长度。
**习题 14-4** 单词方阵(洛谷 P1101)。给一 $n \times n$ 的字母方阵,内可能蕴含多个 yizhong 单词。单词在方阵中是沿着同一方向连续摆放的。摆放可沿着 8 个方向的任一方向,同一单词摆放时不再改变方向,单词与单词之间可以交叉,因此有可能共用字母。输出时,将不是单词的字母用 \* 代替,以突出显示单词。例如:
输入: 输出:
```text
8
qyizhong *yizhong
gydthkjy gy******
nwidghji n*i******
orbzsfgz o**z*****
hhgrhwth h***h***
zzzzozo z*****o**
iwdfrgng i*****n*
yyyygggg y*****g
```
**习题 14-5** 自然数的拆分问题(洛谷 P2404)。任何一个大于 1 的自然数 $n (n \leqslant 8)$ ,总可以拆分成若干个小于 n 的自然数之和。现给出一个自然数 n,求出 n 的拆分成一些数字的和,且每个拆分后的序列中的数字从小到大排序。然后你需要输出这些序列,其中字典序小的序列需要优先输出。例如当输入 6 时,输出:
$1+1+1+1+1+1$ $1+1+1+1+2$ $1+1+1+3$ $1+1+2+2$ $1+1+4$ $1+2+3$ $1+5$ $2+2+2$ $2+4$ $3+3$
**习题 14-6** 湖计数(洛谷 P1596, USACO 2010 October)。由于近期的降雨,雨水汇集在农民约翰的田地不同的地方。用一个 $N \times M (1 \leqslant N, M \leqslant 100)$ 网格图表示。每个网格中有水(W)或是旱地(.)。一个网格与其周围的八个网格相连,而一组相连的网格视为一个水坑。约翰想弄清楚他的田地已经形成了多少水坑。给出约翰田地的示意图,确定当中有多少水坑。
**提示:** 请尝试分别使用深度优先搜索和广度优先搜索解决这个问题。
**习题 14-7** 填涂颜色(洛谷 P1162)。由数字 0 组成的方阵中,有一任意形状闭合圈,闭合圈由数字 1 构成,围圈时只走上下左右 4 个方向。现要求把闭合圈内的所有空间都填写成 2。例如: $6 \times 6$ 的方阵(n=6),涂色前和涂色后的方阵如下:
**涂色前:**
```text
0 0 0 0 0 0
0 0 1 1 1 1
0 1 1 0 0 1
1 1 0 0 0 1
1 0 0 0 0 1
1 1 1 1 1 1
```
**涂色后:**
```text
0 0 0 0 0 0
0 0 1 1 1 1
0 1 1 2 2 1
1 1 2 2 2 1
1 2 2 2 2 1
1 1 1 1 1 1
```
**习题14-8** 字串变换(洛谷P1032,NOIP2002提高组)。已知有两个字串A、B及一组字串变换的规则(至多6个规则):
```text
A_1 → B_1, A_2 → B_2 ……
```
规则的含义为:在 A 中的子串 A\_1 可以变换为 B\_1, A\_2 可以变换为 B\_2……
例如: A=abcd, B = xyz, 变换规则为 abc → xu, ud → y, y → yz。则此时, A 可以经过一系列的变换变为 B, 其变换的过程为: abcd → xud → xy → xyz。共进行了 3 次变换, 使得 A 变换为 B。
输入原字串和目标字串,以及变换规则,如果能在不超过10步内变换完毕,输出最少变换次数,否则输出“NO ANSWER!”。
**习题 14-9** 玉米田迷宫(洛谷 P1825 USACO 2011 Open)。奶牛们去参观了一个玉米迷宫,表示为 $N \times M$ 的矩阵 ( $2 \leqslant N, M \leqslant 300$ ),矩阵中的每个元素都由以下项目中的一项组成。
1. `#`:玉米, 这些格子是不可以通过的。
2. `.`:草地,可以简单地通过。
3. 一个大写字母: 装置的结点, 走上去就会立刻被传送到相对应的另一个结点。总是成对出现。
4. `@`:奶牛目前的位置。
5. `=`:出口
请求出 Bessie 到达出口的最短时间。例如,下面是 $N=5,M=6$ 的迷宫:
```text
###=##
#.W.##
#.####
#.@W##
######
```
最优方案为:先向右走到装置的结点,花费一个单位时间,传送装置的另一个结点上,花费0个单位时间,然后再向右走一格,再向上走一格,到达出口处,总共花费了3个单位时间。
# 第3部分:简单数据结构
## 第15章 线性表
之前已经研究过很多种算法,比如二分法可以用来“给定单调函数,求零点”,冒泡排序可以用来“给定一个数组,将其排序后输出”……算法很有用,接下来要学习的数据结构,也一样很有用。初学数据结构,可能会觉得无从下手,不过不用担心,本书会用很多生活中实际存在的例子来解释这些数据结构。
比如,在商场里面排队结账,或者在网上“秒杀”商品,差别很大,但它们都遵循着相同的规则——讲“先来后到”。早来的,就早买到商品;晚来的,就晚买到商品,甚至可能买不到商品。可以利用“先来后到”这一规则,把这两种排队模式统一起来——它们都是“队列”,都可以用队列这一数据结构来模拟,然后建模,编写计算机程序解决这些问题。
本章将首先开始学习线性表。线性表是最简单、最基本的一种数据结构。一个线性表由多个具有相同类型的数据“串在一起”,每个元素有前驱(前一个元素)后继(后一个元素)。根据不同的特性,线性表也分为栈、队列、链表等。因为这些特性,数据结构可以解决不同种类的问题。图15-1所示为本章思维导图。
 图15-1 本章思维导图
### 15.1 数组
本书已经在第一部分介绍了数组的定义和使用,但是在这里可以重新审视一下作为数据结构的数组。
#### 例 15-1 询问学号(洛谷 P3156)
有 $n(n \leqslant 2 \times 10^{6})$ 名同学陆陆续续进入教室, 已知每名同学的学号(1 到 $10^{9}$ ), 按进教室的顺序给出。上课了, 老师想知道第 i 个进入教室的同学的学号是什么(最先进入教室的同学 i=1), 询问次数不超过 $10^{5}$ 次。
**分析:** 直接建立一个数组按照顺序来记录按顺序到达的同学的学号, 之后直接在数组中查询即可。建立数组的大小至少要超过最多可能的同学总数量(也就是 $2 \times 10^{6}$)。这里可以使用 STL 容器的可变长度数组来记录。可变长度数组的头文件是 ``, 有以下的常用方法。
1. `vector v(N, i)`: 建立一个可变长度数组 v, 内部元素类型为 `int`; 该可变数组最开始有 N 个元素, 每个元素初始化为 i。可以省略 i (默认值为 0), 也可以把 (N,i) 同时省略, 此时这个数组的长度就是 0。内部元素类型可以换成其他的类型, 如 `double`。
2. `v.push_back(a)`: 将元素 a 插入到数组 v 的末尾, 并增加数组长度。
3. `v.size()`: 返回数组 v 的长度。
4. `v.resize(n, m)`: 重新调整数组大小为 n, 如果 n 比原来的小, 则删除多余的信息; 如果 n 比原来大, 则新增的部分都初始化为 m, 其中 m 是可以省略的。
访问或者编辑可变数组时,可以像普通数组一样使用方括号索引,比如 v [10] 就可以访问对应的元素。但是需要特别注意的是,使用方括号索引来访问数组元素时,必须满足 `0 <= i && i < v.size()`,即数组大小严格大于下标 `i`,否则就和访问普通数组越界一样而访问无效内存。不过,可以通过数组初始化、使用 `push_back` 或者 resize 成员函数来增加数组长度。
因此,就本题而言,可以一个一个地把学号读入后使用 `push_back` 将数据一个个地按顺序存入可变数组里,最后询问的时候直接按照下标输出即可,代码如下:
```cpp
#include
#include
using namespace std;
int n, m, tmp;
int main() {
vector stu; // 建立一个一维的可变数组
cin >> n >> m;
for (int i = 0; i < n; i++) {
cin >> tmp;
stu.push_back(tmp); // 把学生按顺序加入到数组中
}
for (int i = 0; i < m; i++) {
cin >> tmp; // 注意最先进入教室的学生是stu[0]
cout << stu[tmp - 1] << endl; // 像数组一样查询
}
return 0;
}
```
#### 例 15-2 寄包柜(洛谷 P3613)
超市里有 $n(n \leqslant 10^{5})$ 个寄包柜。每个寄包柜格子数量不一,第 i 个寄包柜有 $a_{i}(a_{i} \leqslant 10^{5})$ 个格子,不过并不知道各个 $a_{i}$ 的值。对于每个寄包柜,格子编号从 1 开始,一直到 $a_{i}$ 。现在有如下 $q(q \leqslant 10^{5})$ 次操作。
1. 1ijk: 在第i个柜子的第j个格子存入物品 $k(0 \leqslant k \leqslant 10^{9})$ 。当k=0时,说明清空该寄包柜。
2. 2ij: 查询第i个柜子的第j个格子中的物品是什么,保证查询的柜子存过东西。
已知超市里共计不会超过 $10^{7}$ 个寄包格子, $a_{i}$ 是确定然而未知的,但是保证一定不小于该柜子存物品请求的格子编号的最大值。当然,也有可能某些寄包柜中一个格子都没有。
**分析:** 可以建立一个二维数组 `s[i,j]` 记录第 i 个柜子中第 j 个格子中的物品。根据本题的数据规模,需要定义一个大小为 $10^{5} \times 10^{5}$ 的 `int` 数组 ( $4 \times 10^{10}$ 字节,大约 40GB),显然会超出内存限制。依然可以使用 `vector` 来解决。除了上面介绍过的方法,`vector` 还支持下面的一些方法。
1. `vector::iterator it`: 定义一个名字叫作 it 的迭代器。
2. `v.begin()`: 返回数组 v 首元素 (也就是 v [0]) 的指针 (迭代器)。
3. `v.end()`:返回最后一个元素之后的位置的迭代器。它不指向容器中的元素,不能解引用,也不是空指针。空容器的 `begin()` 与 `end()` 相等。
除了使用数组下标,还能通过“迭代器”来访问数组中的元素。迭代器有点类似指针(虽然并不能完全画等号),这里的 it 就可以认为是一个指向 `vector` 中的元素的指针(下文中如果在谈到 STL 元素的指针,一般都指迭代器)。`it` 可通过 `++it` 移向后一个元素,通过 `--it` 移向前一个元素(须保证操作后仍在合法范围内),也能和指针一样用 \*it 取该指针中的元素。
由于迭代器和指针在表现方式上很接近,所以 `v[i]` 和 `*(v.begin() + i)` 是一样的,都是取对应元素的值。其他 STL 容器的迭代器也有类似的性质。然而在算法竞赛中经常只把 `vector` 当作普通的可变数组来使用,比较少用到迭代器。
```cpp
#include
#include
using namespace std;
int n, q, opt, i, j, k;
int main() {
cin >> n >> q; // 寄包柜个数和询问次数
vector> locker(n + 1); // 初始化,一共0到n号寄包柜
while (q--) {
cin >> opt;
if (opt == 1) { // 存包操作
cin >> i >> j >> k;
if (locker[i].size() < j + 1) // 如果这个寄包柜不够大
locker[i].resize(j + 1); // 就扩大新的寄包柜,直到能装下
locker[i][j] = k;
} else {
cin >> i >> j;
cout << locker[i][j] << endl; // 像数组一样输出
}
}
return 0;
}
```
如果要定义由 10 个可变数组组成的一个二维数组, 可以写为 `vector v[10]`。甚至可变数组还能够嵌套, 定义一个二维都不定长的二维数组, 就像 `vector> v` (C++11 及以后的标准允许将结尾的两个 `>` 连写)。
数组作为数据结构可以高效地存储与查询给定索引(下标)的数据,其复杂度都是 O(1),因为这个性质,数组可以用来模拟其他很多的数据结构。但是如果要将整个数组的一段数据进行移位操作(在中间插入删除数据)或者搜索指定元素(如果没有排序),则时间复杂度可达 O(n),效率很低。
### 15.2 栈
#### 例 15-3 洗盘子(1)
小止是餐厅里的洗碗工,她身边有一叠餐盘要洗。客人们吃完饭之后,要洗的盘子会放在这叠餐盘的顶端;而小止洗盘子的时候,总会取出这叠餐盘最顶上的盘子来洗。
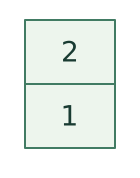
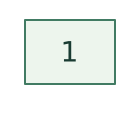
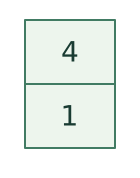
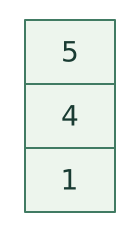
最开始桌子上没有餐盘。一位客人吃完饭了,依次把1、2、3这3个盘子放在了桌子上。现在小止取出了最顶端的3号盘子洗,洗完之后取出现在的顶端盘子2号。又有一个客人吃完了饭,依次放进了4、5这两个盘子。在这之后,小止依次洗完了5、4、1这3个盘子,结束了工作。
研究这一叠盘子,把“放盘子”和“取盘子”视为事件,那么在每一次事件之后,这叠盘子会是什么状态呢?洗盘子的顺序如图15-2所示。
图 15-2 洗盘子的顺序(上方为栈顶)
观察图 15-2 可以发现, 越靠下的元素就越“顽固”, 越靠上的元素就越容易改变? 不难发现: 对于这叠餐盘, 如果 a 比 b 早加入, 那 a 一定比 b 后退出。这种数据结构就是栈。栈是一种“后进先出 (Last In First Out, LIFO)”的线性表, 其限制是仅允许在表的一端进行插入和删除运算。
最后再看一眼“盘子状态”那一列表格,是不是觉得长得很像连绵的山,或是金字塔?请记住这个图像。这种“感性”的理解,有时候也很重要,这有助于提升联想能力。
#### 例 15-4 洗盘子(2)
编写程序模拟小止洗盘子的过程。一个栈可以提供下面几个功能。
1. `void push(int x)`: 将 x 压入栈。对应例子中的“放餐盘”。
2. `void pop()`: 弹出栈顶的元素。对应“取走餐盘”。
3. `int top()`: 查询栈顶的元素由此知道接下来该洗哪个餐盘。
下面给出这些函数的实现(以及加上了一些必要的定义变量):
**代码片段(结合本节的声明和上下文使用):**
```cpp
int stack[MAXN]; // 开辟栈需要的数组空间,其中 MAXN 是栈的最大支持的大小
int p = 0; // 栈顶指针,指向下一个待插入的数组位置
void push(int x) { // 压栈,需要判断栈是否溢出
if (p >= MAXN)
printf("Stack overflow.");
else {
stack[p] = x;
p += 1;
}
}
void pop() { // 弹出栈顶元素,需要判断是否栈为空
if (p == 0)
printf("Stack is empty");
else
p -= 1;
}
int top() { // 查询栈顶元素,需要判断是否栈为空
if (p == 0) {
printf("Stack is empty");
return -1;
} else
return stack[p - 1]; // 注意按照定义方式,p-1 才是栈顶
}
```
一般使用数组来储存栈的数据,同时需要一个栈顶指针记录栈顶的位置。这个栈的栈底是stack [0],栈顶是stack [p-1],当然还有其他的等效的写法,读者可以自行选择。如果想知道栈元素的数量,可以直接查询p即可。为了保证不会出现非法操作(栈溢出或者空栈弹出),在程序中加入了判断栈是否溢出或者是否为空,但是如果保证程序运行过程中不会有非法操作时也可以省略判断部分。
利用上面 3 个函数, 可以重新描述一下小止洗盘子的过程:
**代码片段(结合本节的声明和上下文使用):**
```cpp
push(1);
push(2);
push(3);
printf("Wash[%d]\n", top());
pop();
printf("Wash[%d]\n", top());
pop();
push(4);
push(5);
printf("Wash[%d]\n", top());
pop();
printf("Wash[%d]\n", top());
pop();
printf("Wash[%d]\n", top());
pop();
```
可以使用 STL 提供的 stack 容器, 这能带来很多便利, 不需要去手动实现栈了。如何使用 STL 的 stack 达到和例 15-4 一样的效果呢?
栈的头文件是 ``,有以下几种方法。
1. `stack s;`: 建立一个栈 s, 其内部元素类型是 `int`。
2. `s.push(a)`: 将元素 a 压进栈 s。
3. `s.pop()`: 将 s 的栈顶元素弹出。
4. `s.top()`: 查询 s 的栈顶元素。
5. `s.size()`: 查询 s 的元素个数。
6. `s.empty()`: 查询 s 是否为空。
需要注意的是,这样写虽然方便,但是如果使用 STL 时不打开 -O2 优化,就有一点慢。在非常需要追求运行速度的情况下,往往需要自己手写栈。本书接下来的讨论,将会一直使用 STL。
#### 例 15-5 括号匹配(Uva673)
给定若干字符串,每个字符串由(、)、[、]、{}这6个字符构成。如果所有的括号都可以匹配上,那么这个字符串合法,否则非法。下面给出一些例子。
1. `[({})]`:合法。
2. `()[]()`:合法。
3. `[([]){{[]}}]`:合法。
4. `{]`:非法。
5. `([)(])`:非法。括号的嵌套次序不匹配。
请写一个程序,判断每个给定字符串是否合法。
**分析:** 将这个字符串从左往右写, 一旦遇到匹配上的括号, 就把这对括号擦掉, 就像“消消乐”一样。
以 `[([]){}]` 为例,从左向右扫描:先将三个左括号 `[([` 入栈;读到 `]` 时弹出匹配的 `[`,读到 `)` 时弹出 `(`,此时栈中只剩最外层的 `[`。接着读入 `{`,再用 `}` 将它匹配并弹出;最后的 `]` 弹出最外层的 `[`。全部字符处理完且栈为空,所以序列合法。
如果处理字符串的所有字符,发现纸上还剩有括号,那么就说明有些括号没有被匹配到,说明是非法的括号序列。例如,对 `([)()` 按上面的方法处理,就可以知道这是一个非法的序列。
根据上面的分析,可以写出如下代码:
```cpp
#include
#include
#include
#include
using namespace std;
stack s;
int num;
char trans(char a) { // 根据后面的括号找到前面对应的括号
if (a == ')')
return '(';
if (a == ']')
return '[';
if (a == '}')
return '{';
return '\0';
}
int main() {
cin >> num;
string p;
getline(cin, p); // 读掉上一行末尾的换行符
while (num--) {
while (!s.empty())
s.pop(); // 清除
getline(cin, p); // 读入一行
for (int i = 0; i < p.size(); ++i) {
if (s.empty()) { // 如果栈为空,直接放入栈中
s.push(p[i]);
continue;
}
if (trans(p[i]) == s.top())
s.pop();
else
s.push(p[i]);
}
if (s.empty())
printf("Yes\n");
else
printf("No\n");
}
return 0;
}
```
这里遇到了 C++ 中处理字符串问题的一个坑点: 使用 `cin` 读入一个独占的数字后, 其读入指针在这一行的末尾, 如果再使用 `getline` 读入一行字符串时, 只会读到空串 (第一行)。如果希望读到第二行, 则必须要假装读入这一行, 可以使用 `getline`, 也可以使用 `getchar` 等。
#### 例 15-6 后缀表达式(洛谷 P1449)
平常写表达式,一般运算符在数的中间,比如 $1+3*5$ ,其中 + 在 1 和 $3*5$ 之间,\* 在 3 和 5 之间,这种表达式称为中缀表达式。中缀表达式很好用,但是计算机可能没那么喜欢中缀表达式。有一种表达式对计算机很友好,叫作“后缀表达式”。顾名思义,后缀表达式中运算符在参数的后面。
对于计算机而言,后缀表达式当然比中缀表达式更容易计算。另外,后缀表达式可以避免掉括号,这也是它相对于中缀表达式的一大优势。请写一个程序,输入一个长度不超过1000的字符串,求后缀表达式的值。保证后缀表达式中仅有整数和四则运算符号。
例如,输入“2.4.\*1.3.+-@”,其中.是每个数字的结束标志;@是整个表达式的结束标志。输出“4”。
**分析:** 阅读一个后缀表达式的方法是:从左往右读式子,一旦遇到运算符,就往前取n个数——这个n取决于运算符有多少个参数——然后擦掉这些参数和这个运算符,把计算结果写在那里。接下来,重复刚才的操作,直到表达式中只剩下一个数为止。
对于后缀表达式 $24 * 13 + -$ ,处理方法如下:首先从左往右读,读到了乘号。乘法有两个参数,所以取出前面的2和4,算出 $2 * 4 = 8$ 。现在,擦掉 $24^{*}$ ,写上8,式子变成: $813 + -$ 。读到加号之后,取出前面的1和3,算出 $1 + 3 = 4$ ,把式子改写成: $84 -$ 。
接着,还是从头开始读这个式子。读到减号之后取出8和4,算出 $8 - 4 = 4$ ,于是最后的式子就是4。这就是期望的结果。事实上,与这个后缀表达式相对应的中缀表达式是 $2^{*}4 - (1 + 3)$ 。代码如下:
```cpp
#include
#include
using namespace std;
stack n;
int s = 0, x, y;
int main() {
char ch;
do {
ch = getchar();
if (ch >= '0' && ch <= '9')
s = s * 10 + ch - '0';
else if (ch == '.')
n.push(s), s = 0;
else if (ch != '@') {
x = n.top();
n.pop();
y = n.top();
n.pop();
switch (ch) {
case '+':
n.push(x + y);
break;
case '-':
n.push(y - x);
break;
case '*':
n.push(x * y);
break;
case '/':
n.push(y / x);
break;
}
}
} while (ch != '@');
printf("%d\n", n.top());
return 0;
}
```
在这里,越早写下的括号,离可能产生匹配的地方越远,当然也越晚得到匹配。这样的做法符合“先进后出”,所以可以用栈来模拟这个操作。
判断一个过程能否用栈来模拟,当然是看能否满足“后进先出”或者“先进后出”。
### 15.3 队列
#### 例 15-7 超市排队(1)
这回小止作为一个收银员在超市打工。收银员会给排在队伍最前面的顾客结账,然后服务队伍中的下一个顾客。而队伍的末尾也一直会有更多的顾客依次加入队列。
最开始时,收银台前面一个人都没有。然后顾客1、顾客2和顾客3排入了队列。收银员给顾客 1 结账后又给顾客 2 结账。这时,顾客 4 和顾客 5 又加入了队列。在此之后,收银员又给顾客 3、顾客 4 和顾客 5 结账。此时所有顾客都已经结账,收银台前又没有人了。
把“收银员结账”和“新顾客加入队列”视为事件,那么每次事件之后,队伍会是什么情况呢?排队结账的情况如图15-3所示。
 图15-3 排队结账的情况
可以发现,如果顾客 a 比顾客 b 先排入队伍,那么顾客 a 比顾客 b 先结账完成。这种数据结构就是队列。队列是一种“先进先出(First in First Out, FIFO)”的线性表,其限制是允许在表的一端进行删除运算,另外一端进行插入运算。
#### 例 15-8 超市排队(2)
编写程序模拟收银过程。一个队列可以提供下面几个功能。
1. `void push(int x)`: 将 x 压入队列。一个人来排队了, 他应该站在队尾。
2. `void pop()`: 弹出队首的元素。排在最前面的人结完了账, 离开队列。
3. `int front()`: 查询队首的元素。这样可以知道现在应该给谁结账。
下面给出这些函数的实现。
**代码片段(结合本节的声明和上下文使用):**
```cpp
int queue[MAXN]; /* 开辟队列需要的数组空间,其中 MAXN 是队列的最大能入队元素的次数 */
int head = 0; // 队首指针
int tail = 0; // 队尾指针,如果有新的元素插入,就会插入到这个位置
void push(int x) { // 进队,需要判断队伍是否溢出
if (tail >= MAXN)
printf("Queue overflow.");
else {
queue[tail] = x;
tail += 1;
}
}
void pop() { // 弹出队首元素,需要判断是否队列为空
if (head == tail)
printf("Queue is empty");
else
head += 1;
}
int front() { // 查询队首元素,需要判断是否队列为空
if (head == tail) {
printf("queue is empty");
return -1;
} else
return queue[head];
}
```
考虑到如果队列数组的实现和现实中的收银台一样,每次查询数组第一个元素,退出队列时队列中的所有元素都往前面移动一格,那么运行效率是非常低的。可以让队伍本身保持静止,而“收银员”却从前往后依次移动,每次服务完一个顾客就往后面走服务下一个顾客,这样就避免了数组整体的移动。
队列和栈的程序实现很相似。队列和栈不同的地方就是:栈只有一个端口出入;而队列是后端入,前端出,所以需要头尾两个指针。依靠上面3个函数,使用代码来描述收银的过程:
**代码片段(结合本节的声明和上下文使用):**
```cpp
push(1);
push(2);
push(3);
printf("Serve customer: [%d]\n", front());
pop();
printf("Serve customer: [%d]\n", front());
pop();
push(4);
push(5);
printf("Serve customer: [%d]\n", front());
pop();
printf("Serve customer: [%d]\n", front());
pop();
printf("Serve customer: [%d]\n", front());
pop();
```
STL 中的队列由头文件 `` 提供。常用方法如下:
| 写法 | 含义 |
| --- | --- |
| `queue q;` | 建立元素类型为 `int` 的空队列 |
| `q.push(x)` | 将 `x` 加入队尾 |
| `q.pop()` | 删除队首元素,不返回该元素 |
| `q.front()` | 访问队首元素 |
| `q.back()` | 访问队尾元素 |
| `q.empty()` | 判断队列是否为空 |
| `q.size()` | 返回元素个数 |
调用 `pop()`、`front()` 或 `back()` 前,必须确保队列非空。
#### 例 15-9 约瑟夫问题(1)(洛谷 P1996)
一群小朋友坐成一个圈,已经按照 1,2,…,n 编号。从 1 号小朋友开始报数,报到 k 的小朋友出局;下一个小朋友继续从 1 开始报。显然,游戏进行到最后,场上只会剩下一个小朋友。此时这个小朋友获胜。现在的问题是,给定 n 和 k,输出全部 $n$ 个小朋友的出局顺序,最后输出获胜的小朋友编号。
**分析:** 乍一看这和队列好像没有什么关系。但是来考虑这样的情景:1,2,…,n这些小朋友站在队列里。接下来,队首的人出队,然后走到队尾,这样一直循环,直到第k个小朋友。他被淘汰出局,不再入队。队内现在只剩下了n-1名小朋友,继续重复刚刚的操作:前k-1个人出队之后走到队尾,接下来那位小朋友直接被淘汰。利用这个队列,即可模拟约瑟夫问题的游戏过程。核心代码如下:
**代码片段:** 需要头文件 ``、`` 及 `using namespace std;`,调用前给 `n`、`k` 赋正整数。循环会输出完整出局顺序,包括最后一名小朋友。
**代码片段(结合本节的声明和上下文使用):**
```cpp
queue q;
int n, k;
void work() {
int i;
for (i = 1; i <= n; i++)
q.push(i); // 初始加入小朋友
while (q.size() != 1) { // 当不是剩余一人时
for (i = 1; i < k; i++) {
q.push(q.front()); // 将队首放入队尾
q.pop();
}
printf("%d\n", q.front()); // 报到第 k 个的小朋友被淘汰
q.pop();
}
}
```
如果数据有先进先出的性质,那么可以考虑使用队列;队列常常使用在各类广度优先搜索算法上。
### 15.4 链表
#### 例 15-10 排队记录
n 名同学在排队进入洛谷大厦, 然后解散自由活动。现在希望知道当初排队的顺序, 然而并没有记录队伍是怎么排的。但好消息是, 已经知道止止 (编号是 1) 排在最前面; 除此之外, 每人都记得自己后面是谁。如何利用这些信息, 还原出那天晚上的排队顺序呢?
假设这些同学的编号从1到4,他们记得站在后面的同学分别是4、3、0、2(0说明后面没有人)。能推算出原来他们排队的顺序是什么吗?可以用Next[x]来表示x这个用户后面排的是谁。特殊地,`Next[x]=0`表示x后面没有人了。那么,很容易写出代码:
**代码片段(结合本节的声明和上下文使用):**
```cpp
for (int i = 1; i != 0; i = Next[i])
printf("%d ", i);
```
问题就这样以 $O(n)$ 的复杂度解决了。回头来看, 这个问题引出一个非常重要的启示: 如果知道每个元素之前 / 之后是谁, 就可以恢复整个表的排列顺序。利用这种方式, 来存储元素排列顺序的表, 称为链表。
接下来,考虑另外一个问题。本来 n 名同学在好好地排队,但是来了 1 名不守规矩的同学 (5 号),插队到 4 号后面,而其余的同学顺序不变。插队之后,队伍是什么样的顺序呢?
马上可以想到一个暴力的做法:使用数组记录排队顺序;发生插队的时候,把插队者放到对应的地方,其余元素后移一位。这样,处理每个插队者的时间复杂度是 $O(n)$ , 如果有 m 人插队,总复杂度将会达到 $O(mn)$ 。
有没有快一点的方式呢?已经知道,如果知道每个元素之后是谁,就可以恢复整个表的排列顺序。如何用这个思路来完成这个问题?还是以 Next [x] 来表示 x 后面是谁。那么一个插队行为“y 插到了 x 的后面”,就是:x 后面变成了 y;y 后面变成了原本在 x 后面的人。代码如下:
**代码片段(结合本节的声明和上下文使用):**
```cpp
void insert(int x, int y) {
Next[y] = Next[x];
Next[x] = y;
}
```
这时,有另外1名同学(2号)等不及了,退出了队伍。这个事情如何实现呢?来考虑“x后面那个同学退出队伍”对Next数组的影响,这里的x是原来2号同学的前一名同学,也就是5号。Next [x]同学退出,相当于x的后继,直接变成了Next [x]的后继。所以代码如下:
**代码片段(结合本节的声明和上下文使用):**
```cpp
void remove(int x) { // x 后面的同学离开
Next[x] = Next[Next[x]]; // 更新后继
}
```
这里必须要知道 x 的前面一名同学是谁才能删除 x。如果只知道要删除 x 而不知道它前面一名同学是谁则无法删除。所幸根据下面提到的双链表,就能很方便地知道每个元素前面是谁了。
链表的插入和删除过程如图 15-4 所示。
每次插队操作, 只需要修改两个 Next 值, 显然是 $O(1)$ 的复杂度; 删除操作也可以同理分析。
 图15-4 链表的插入和删除过程
最后只需要像第一个例子一样,通过 Next 数组就能得到最后的排队顺序,以 $O(n)$ 的时间复杂度完成了本题。
虽说“每个结点可以找到自己相邻结点”的表就是链表,不过链表有很多种。下面列举一些。
1. 单链表: 每个结点记录自己的后继。
2. 双链表:每个结点记录自己的前驱和后继。与单链表只能往后走相比,它的好处是可以向前、向后走。
3. 循环单链表:本身是一个单链表,但是最后一个结点的后继为第一个结点,从而连成了环形结构。
4. 循环双链表: 本身是一个双链表, 连成环形。
5. 块状链表(仅作知识拓展,无需学习): 这是一种特殊的链表。基本思想是将若干元素压缩成一块, 将这些块串联起来。
6. 跳表(Skip List, 仅作知识拓展, 感兴趣的读者可以学习): 这是一种非常有趣的数据结构, 相当于平衡树。每个结点拥有自己的右指针和下指针, 通过分层的方式来加速查询, 而每个元素的层数由概率决定。
#### 例 15-11 排队模拟
实现一个数据结构,维护一张表(最初只有一个元素 1)。需要支持下面的操作,其中 x 和 y 都是 `int` 范围内的正整数,且都不一样,操作数量不多于 2000。
1. ins\_back(x,y): 将元素 y 插入到 x 后面。
2. ins\_front(x,y): 将元素 y 插入到 x 前面。
3. ask\_back(x): 询问 x 后面的元素。
4. ask\_front(x): 询问 x 前面的元素。
5. del(x): 从表中删除元素 x, 不改变其他元素的先后顺序。
**分析:** 用双向链表维护,`head` 记录当前头结点,编号 0 表示没有结点。开始前调用 `init()` 建立只含元素 1 的初始表。输入保证新插入的正整数互不重复;查询元素或其邻居不存在时返回 0。下面给出实现:
**代码片段(结合本节的声明和上下文使用):**
```cpp
#include
const int MAX_NODE = 2005; // 初始结点 + 最多 2000 次插入
struct node {
int key, pre, nxt;
node(int k = 0, int p = 0, int n = 0) : key(k), pre(p), nxt(n) {}
};
node s[MAX_NODE];
int head = 0, tot = 0;
void init() { // 开始处理操作前调用一次
tot = head = 1;
s[0] = node();
s[1] = node(1);
}
int find(int x) {
int now = head;
while (now && s[now].key != x)
now = s[now].nxt;
return now;
}
void ins_back(int x, int y) {
int now = find(x);
if (!now) return; // x 不存在时不执行插入
assert(tot + 1 < MAX_NODE);
int right = s[now].nxt;
s[++tot] = node(y, now, right);
if (right) s[right].pre = tot;
s[now].nxt = tot;
}
void ins_front(int x, int y) {
int now = find(x);
if (!now) return;
assert(tot + 1 < MAX_NODE);
int left = s[now].pre;
s[++tot] = node(y, left, now);
if (left) s[left].nxt = tot;
else head = tot;
s[now].pre = tot;
}
int ask_back(int x) {
int now = find(x);
return now && s[now].nxt ? s[s[now].nxt].key : 0;
}
int ask_front(int x) {
int now = find(x);
return now && s[now].pre ? s[s[now].pre].key : 0;
}
void del(int x) {
int now = find(x);
if (!now) return;
int left = s[now].pre, right = s[now].nxt;
if (left) s[left].nxt = right;
else head = right;
if (right) s[right].pre = left;
s[now] = node();
}
```
以上代码虽然实现了链表的各项基本操作,但是效率并不高。这是因为每次操作时都要调用 find 函数以查找 x 所在的结点编号,这个过程的时间复杂度是 $O(n)$ 。但是也有改进方法:创建一个数组,用于存放每个数字对应的结点编号来代替 find 函数。如果数字的范围非常大(比如 `int` 范围),无法创建这么大的数组,也可以使用 Hash 算法或者 map 容器来记录结点编号,这在本书的第 17 章会介绍到。
#### 例 15-12 队列安排(洛谷 P1160)
一个学校里老师要将班上 N 个同学排成一列,同学被编号为 1~N,他采取如下的方法:
1. 先将 1 号同学安排进队列, 这时队列中只有他一个人。
2. 2~N 号同学依次入列, 编号为 i 的同学的入列方式为: 老师指定编号为 i 的同学站在编号为 1~i-1 中某位同学 (即之前已经入列的同学) 的左边或右边。
3. 从队列中去掉 $M(M
using namespace std;
struct node {
int pre, nxt, key;
node(int _key = 0, int _pre = 0, int _nxt = 0) // 结构体初始化
{
pre = _pre;
nxt = _nxt;
key = _key;
}
};
node s[100005];
int n, m, tot = 0, index[100005] = {0}; // 记录每个位置的结点编号
void ins_back(int x, int y) {
int now = index[x]; // 查找索引
s[++tot] = node(y, now, s[now].nxt);
s[s[now].nxt].pre = tot;
s[now].nxt = tot;
index[y] = tot; // 记录索引
}
void ins_front(int x, int y) {
int now = index[x];
s[++tot] = node(y, s[now].pre, now);
s[s[now].pre].nxt = tot;
s[now].pre = tot;
index[y] = tot;
}
void del(int x) {
int now = index[x];
int le = s[now].pre, rt = s[now].nxt;
s[le].nxt = rt;
s[rt].pre = le;
index[x] = 0;
}
int main() {
int x, k, p, now;
cin >> n;
s[0] = node(); // 代码技巧:令 0 恒为最左边的结点,有利于之后处理问题
ins_back(0, 1);
for (int i = 2; i <= n; i++) {
cin >> k >> p;
p ? ins_back(k, i) : ins_front(k, i);
}
cin >> m;
for (int i = 1; i <= m; i++) {
cin >> x;
if (index[x])
del(x);
}
now = s[0].nxt;
while (now) {
cout << s[now].key << ' ';
now = s[now].nxt;
}
return 0;
}
```
其实删除操作也不是必要的。考虑最后输出的过程,相当于同学们从左到右报出自己的编号。其实可以不去真的执行删除操作,而是叫这些“被删除”的同学在报数时闭嘴(建立一个shutup数组用于记录学生是否闭嘴)。这样可以假装他们不存在。正确性是显然的——这并没有破坏其他同学报数的顺序。
#### 例 15-13 约瑟夫问题(2)(洛谷 P1996)
题目描述同例 15-9。
**分析:** 除了可以使用队列,本题也适合使用链表实现,因为从队列中出局的小朋友知道他的前面和后面,所以使用链表删除结点效率很高。链表一样可以使用 STL 来简化操作,链表需要使用 list 的头文件,支持以下的常用方法。
1. `list a;`:定义一个存储 `int` 的链表。
2. `int arr[5] = {1, 2, 3}; list a(arr, arr + 3);`:用数组的前 3 个元素初始化链表。
3. `a.size()`:返回链表的元素数量。
4. `list::iterator it;`:声明一个迭代器。
5. `a.begin()`、`a.end()`:分别返回首元素迭代器和尾后迭代器;尾后迭代器不能解引用。
6. `it++`、`it--`:分别向后、向前移动迭代器,注意不能越过有效范围。
7. `a.push_front(x)`、`a.push_back(x)`:分别在开头、末尾插入元素。
8. `a.insert(it, x)`:在 `it` 指向的元素前插入元素。
9. `a.pop_front()`、`a.pop_back()`:分别删除首元素、末元素;链表须非空。
10. `a.erase(it)`:删除 `it` 指向的元素,返回其后继的迭代器。
11. `for (it = a.begin(); it != a.end(); it++)`:遍历链表。
模拟题意即可。首先将所有同学按照顺序使用链表连接,然后从第一位同学开始数数,数到 m 时就把对应的元素输出,同时删除这个元素,直到链表为空为止。由于是首尾相接,所以是循环链表,只需要遍历到链表尾部,则立刻从头开始。代码如下:
```cpp
#include
#include